
如何使用 LXML 获取文本
您需要使用 XPath 选择器来获取数据。如果您需要复习一下,请参阅XPath 教程。
步骤 1.使用 pip 安装 LXML。
pip install lxml
					from lxml import etree
import requests
例子1
步骤 2.首先,我们来检查目标页面的源代码。在本例中,我们将使用“最佳住宅代理服务提供商”页面。您可以在带有品牌类名的div 元素中找到服务提供商的名称。
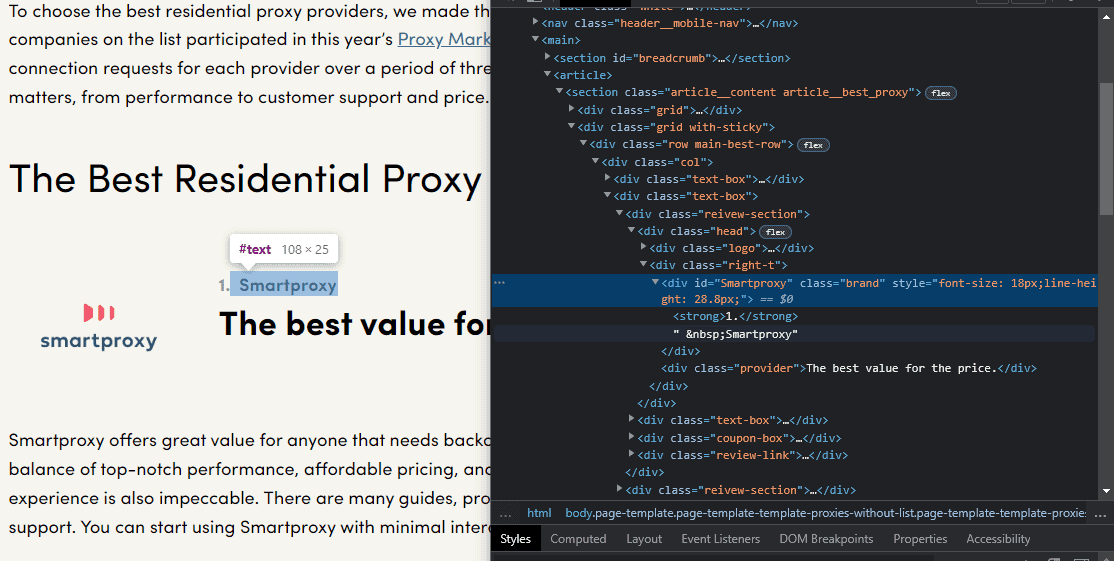
步骤 3.然后,发出 HTTP 请求并将响应赋值给r变量以抓取网站。
r=requests.get("https://proxyway.com/best/residential-proxies")
步骤 4.使用LXML 提供的etree.HTML()解析器解析 HTML 响应内容。
tree = etree.HTML(r.text)
步骤 5.选择包含类名brand的div元素,并获取文本元素。
divs = tree.xpath(".//div[@class='brand']/text()")
让我们仔细看看代码:
- .//div - 全选 申报单 在 HTML 文档中。
- .//div[@class='品牌'] - 全选 申报单 有一类 牌。
- /文本() – 获取包含在 DIV.
注意: 结果是 LXML 元素的列表。
步骤 6.让我们打印出div列表。可以看到,其中还包含我们不需要的空格和不间断空格(\xa0 元素):
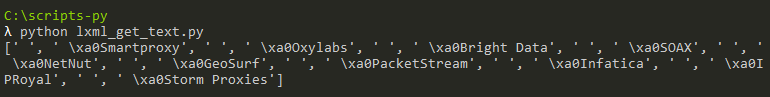
您可以清理结果并将它们分配给一个新的brand_names 列表:
					brand_names = []
for div in divs:
    if len(div.strip()) > 0:
        brand_names.append(div.strip())
这是脚本的输出结果,显示了您刚刚抓取的提供商名称。
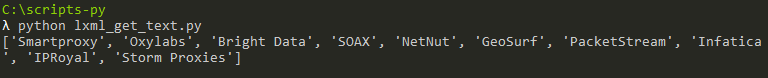
结果:恭喜,您已成功提取内容。以下是完整脚本:
					from lxml import etree
import requests
r=requests.get("https://proxyway.com/best/residential-proxies")

tree = etree.HTML(r.text)

divs = tree.xpath(".//div[@class='brand']/text()")

brand_names = []
for div in divs:
    if len(div.strip()) > 0:
        brand_names.append(div.strip())
#print (brand_names)
例子2
r=requests.get("https://books.toscrape.com")
步骤 4.使用LXML 提供的etree.HTML()解析器解析 HTML 响应内容。
tree = etree.HTML(r.text)
步骤 5.现在我们通过检查代码来获取书名。书名位于一个带有product_main类的div 标签内的h1标签中:

XPath 应如下所示:
title = tree.xpath("//div[@class='col-sm-6 product_main']/h1/text()”)[0]
注意:但是,这样做行不通,因为还存在另一个类——col -sm-6。因此,XPath 选择器找不到这个特定的div 元素。
步骤 6.让我们指定两个类,以便 XPath 能够正常工作。
title = tree.xpath("//div[@class='col-sm-6 product_main']/h1/text()”)[0]
您也可以使用contains()方法作为替代方案:
					title = tree.xpath("//div[contains(@class,'product_main')]/h1/text()")[0]
print (f'Title: {title}')
让我们仔细看看代码:
- (@班级) – 从文档中选择所有类别。
- //div([包含(@class,'product_main']) – 选择 DIV 包含一个 product_main 类。
- /小时1 – 标题文本不在 div 本身中,而是在其 子元素。
- /h1/文本() – 从中获取文本 标签。
- [0] –自 树.xpath() 方法返回一个列表,我们想要文本,我们可以简单地抓取该列表的第一个元素。
步骤 6。 现在让我们来了解一下这本书的描述。 它可以在 标签下方没有任何描述属性 DIV,其中包含其标题。

获取描述文本并避免选择任何其他不相关的<p>元素的一种方法如下所示:
					description = tree.xpath("//div[@id='product_description']/following-sibling::p/text()")[0]
print (f'Description: {description}')
- //div[@id='产品描述'] – 我们选择 DIV 与 id of 产品描述 这样我们就不会选择错误的元素。
- /关注兄弟姐妹::p – 选择下一个 兄弟姐妹 DIV 我们之前已经选择过。您可以获取有关 Xpath 轴的更多信息 开始.
- /文本() – 获取文本 标签。

结果:恭喜,您已成功提取书籍名称和简介。以下是完整脚本:
					from lxml import etree
import requests

r=requests.get('https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html')

tree = etree.HTML(r.text)

title = tree.xpath("//div[contains(@class,'product_main')]/h1/text()")[0]
print (f'Title: {title}')

description = tree.xpath("//div[@id='product_description']/following-sibling::p/text()")[0]
print (f'Description: {description}')