
9 年网页抓取时绕过 Cloudflare 的 2026 种最佳方法
网站不喜欢机器人到处爬行,因此它们使用 Cloudflare 等反机器人措施来阻止它们。如果您希望从受 Cloudflare 保护的网站抓取数据,您需要知道如何绕过它。让我们来看看如何实现这一点。

如果您曾经遇到过带有橙色云的 CAPTCHA,要求您勾选您是人类的复选框,那么恭喜您 - 您已经对 Cloudflare 的服务有所熟悉了。
Cloudflare是一家提供内容分发网络(CDN)服务的公司,旨在提升网站性能和安全性。除了优化网站性能外,Cloudflare还能保护网站免受DDoS攻击以及其他恶意和不必要的机器人流量的侵害。但是,网络爬虫呢?
不幸的是,爬虫程序被识别为机器人程序,因此经常被阻止。虽然 Cloudflare 允许一些经过验证的机器人程序流量通过(即 Google 的索引网页的爬虫程序),但机器人保护系统很少知道好机器人程序和坏机器人程序之间的区别。而且,网络爬虫程序通常被解释为坏的。但是,如果您想在不被阻止的情况下爬取受 Cloudflare 保护的网站,有办法绕过此安全层。
Cloudflare 的反机器人保护是什么?
Cloudflare 以其 Cloudflare Bot Management 而闻名,旨在保护网站免受自动攻击和恶意机器人的侵害。它提供针对各种威胁的高级保护,包括凭证填充、网络绕过和帐户接管。
Cloudflare 的 Bot 管理功能包含一个Web 应用程序防火墙 (WAF) ,它利用流量模式和高级算法来识别威胁,并阻止恶意流量到达网站的源服务器。
此外,DNS绕过功能可以区分已知的合法机器人和潜在的有害机器人。这使得合法的机器人(例如网络爬虫)能够访问网站而不被安全措施阻止,但会阻止可疑的机器人。
Cloudflare 错误和响应代码
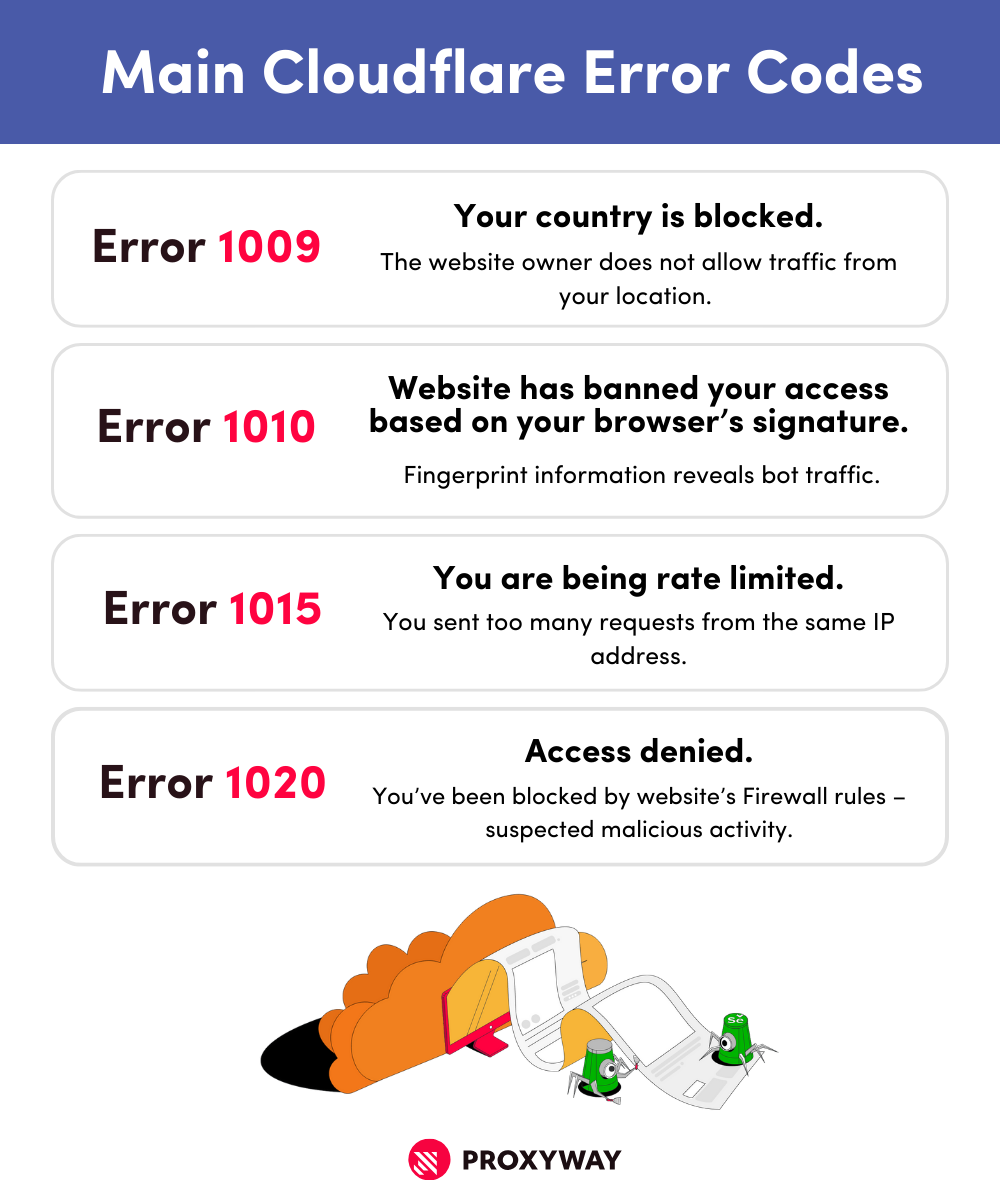
当 Cloudflare 阻止您访问特定网站时,您将看到一个错误代码,该代码解释了阻止的原因。以下是您可能遇到的一些最常见的 Cloudflare 错误代码。
Cloudflare 错误 1020:访问被拒绝。Cloudflare并未说明此错误的具体原因,但表示客户端或浏览器已被 Cloudflare 客户(网站)的防火墙规则阻止。原因可能是受 Cloudflare 保护的网站检测到恶意活动、将您识别为机器人,或者您被拒绝访问特定页面(例如,管理面板)。
Cloudflare 错误 1010:此网站的所有者已根据您的浏览器签名禁止您访问。由于您的浏览器签名,您访问某些数据的请求已被阻止。这种情况通常发生在抓取工具暴露指纹信息时(通常指纹信息不完整或不具有人类指纹的独特性),Cloudflare 检测到该信息后才会发生。
Cloudflare 错误 1015:您的流量已被限制。您从同一 IP 地址发送了过多请求,已被阻止。正常用户流量很少受到限制,因此您需要使用不同的 IP 地址发送请求,或者减少请求数量。
Cloudflare 错误 1009:您的国家/地区已被屏蔽。这是一个典型的 Cloudflare 错误代码,但与您的爬虫程序无关。此错误表示网站所有者只允许来自特定国家/地区的流量,而您的国家/地区不在列表中。
Cloudflare 如何检测网络爬虫?
Cloudflare 使用两种方法来检测网络爬虫:被动式和主动式。被动式方法是指使用后端指纹识别测试,而主动式方法则依赖于客户端分析。
被动检测方法
Cloudflare 会检查您的IP 地址信誉,以区分您是机器人还是真人。例如,真人通常使用住宅或移动 IP 地址浏览网页,因为这些地址由他们的互联网服务提供商 (ISP) 分配。相比之下,数据中心 IP 地址通常被网络爬虫或数据抓取工具等自动化系统使用。因此,访问使用数据中心 IP 地址的网站的用户很可能不是真人。
此外,曾用于网络钓鱼、诈骗或其他恶意活动的IP地址将被封禁。因此,如果您在网页抓取工具中使用代理服务,请确保该服务提供商提供信誉良好的IP地址。
Cloudflare 也会追踪僵尸网络。它会存储与这些网络相关的 IP 地址、设备甚至行为模式等信息。因此,它会屏蔽疑似属于僵尸网络的 IP 地址和ASN,或者向其发送客户端挑战(例如“3+7 等于多少?”或“选择所有红色图形”),以证明其为真人操作。
HTTP 请求头(客户端浏览器信息)也可用于区分机器人和真人用户。来自真人用户的请求头包含详细的用户代理字符串,其中定义了操作系统、浏览器版本和其他参数。此外,还有保存的 cookie,用于匹配 IP 地址和地理位置。然而,机器人往往缺少或不匹配这些信息。
主动检测方法
为了验证用户是否为机器人,受 Cloudflare 保护的网站会显示Turnstiles——一种非交互式的验证码替代方案。只有当您的流量看起来可疑时,才会显示这些工具。例如,如果您缺少用户代理字符串、存在异常的网页交互或使用了数据中心 IP 地址。Cloudflare 检查您的参数并确认您是真人后,Turnstile 会自动完成验证,您将看到“成功!”消息。

使用代理或 VPN 服务会增加遇到 Turnstiles 的机会。因此,如果您使用代理进行网页抓取,请记住抓取工具需要能够模仿人类的浏览方式才能避开 Turnstiles。
此外,Cloudflare 使用Canvas 指纹识别技术,通过检查用户的设备类别来检测自动化活动。设备类别指的是浏览器、操作系统甚至硬件参数的组合。它由三层定义:硬件(GPU)、底层软件(已安装的字体、像素渲染)和高层软件(Web 浏览器)。这些参数的组合会生成一个唯一的指纹,Cloudflare 可以检测到您是否试图伪造这些指纹。
但这还不是全部。Cloudflare 还具备事件追踪功能。它会检查鼠标活动,例如移动、滚动和点击,以及您按下的键盘按键。通常,人们需要使用鼠标和键盘来浏览网页,因此,如果您的爬虫点击次数不足或根本不移动鼠标,就会引起怀疑。
如何在网页抓取时绕过 Cloudflare 机器人管理
有几种方法可以避免在网页抓取时遇到 Cloudflare 问题。虽然没有完美的方法,但这些工具可以帮助相当简单地绕过 Cloudflare。
使用无头浏览器
像 Selenium 或 Puppeteer 这样的无头浏览器,本质上就是普通的浏览器,只是没有用户界面。它们没有按钮、地址栏,也没有其他任何可交互的元素。你需要通过编程的方式来操控它们。那么,无头浏览器是如何帮助绕过 Cloudflare 的呢?在处理受 Cloudflare 保护的网站时,使用无头浏览器有几个优势。
- 您还可以 自定义 HTTP 浏览器标头。您可以设计它们来模仿真实的人类用户代理字符串、语言选择、cookie 等。通过创建类似人类的浏览器标头,您可以诱骗 Cloudflare 允许您的抓取机器人成功运行。
- 他们做了 交互看起来像人类。爬虫在访问网站时通常非常有条理。而人类则更加混乱,并且有独特的模式。例如,我们倾向于先访问登录页面,然后转到产品选择,来回浏览直到我们做出选择,等等。无头浏览器可以模仿真实的浏览模式和网络交互,例如浏览速度、类似人类的打字、鼠标移动。
- 无头浏览器可以得到强化。 有几种适用于无头浏览器的插件,如 Selenium 和 Puppeteer,可以对其进行修补和优化,使其看起来更像人类。这些插件(您可以在 GitHub 上找到它们)可以帮助伪造指纹、修改和旋转用户代理字符串、模拟类似人类的浏览等等。这对于抓取任务尤其重要,因为它可以阻止指纹泄露并修复有助于 Cloudflare 将浏览器识别为机器人的参数。
使用代理
代理服务器是您和网络服务器之间的中介。它们会将您的流量路由到不同的 IP 地址,并隐藏您的原始地址和位置。如前所述,人类几乎从不使用数据中心 IP 地址浏览网页。因此,为了防止被检测到,为您的网络爬虫选择住宅或移动代理服务器至关重要。
- 请求看起来更加自然。 在抓取网页时,您的抓取工具会向网站的服务器发送大量请求。如果您用太多请求限制服务器,您将被阻止。因此,使用不同的 IP 并轮换它们是个好主意。大多数代理服务都提供相当大的 IP 池、许多地理位置以及轮换代理的选项。这样,您可以让您的抓取工具的请求看起来更分散、更自然——就好像它们来自不同的人一样。
- 您可以访问受地理限制的内容。 代理可以帮助您避免 Cloudflare 错误 1009。将您的 IP 地址设置为网站允许的 IP 地址,将使您有机会访问和抓取网站(如果它们在您的实际位置受到地理限制)。
使用 Web 抓取 API
抓取缓存版本
由于 Cloudflare 允许网络爬虫,因此您可能有一个要抓取的网站的索引和缓存版本。因此,您可以抓取缓存版本,而不必自己尝试绕过 Cloudflare。
要抓取 Google 缓存,请添加 https://webcache.googleusercontent.com/search?q=cache: 到您要抓取的 URL 的开头。
例如,如果您想抓取 Proxyway 的主页,您的 URL 应该是这样的: https://webcache.googleusercontent.com/search?q=cache:https://www.proxyway.com/
虽然这种方法是一种经济有效的解决方案,但它是最不可预测的。缓存可能太旧,特别是当您正在寻找新数据时。或者您的目标网站根本没有缓存。如果您检查网络缓存页面,它会告诉您上次快照的时间,因此请确保这些数据仍然可用。

此外,一些网站(例如 LinkedIn)会告诉 Google 爬虫不要缓存他们的网页,因此您将无法完全抓取缓存。
绕过 Cloudflare 的替代方法
如果由于某种原因,上述方法对您不起作用,您可以尝试一些其他方法来绕过 Cloudflare。
- Cloudflare 求解器 经常被用来绕过 Cloudflare 的安全措施,例如揭露指纹欺骗或检测非人类浏览行为。有几种 Cloudflare 解决方案和库可用,一些是开源的,一些是付费的。然而,它们往往无法跟上 Cloudflare 的保护方法,而这些方法正变得越来越难以绕过。
- Cloudflare 仅阻止通过其网络的请求。相反,您可以尝试 向源服务器发送请求。调用源服务器,找到托管内容的服务器的 IP 地址,然后您可以直接发送请求,绕过 Cloudflare。但是,这种方法相当具有挑战性——很难找到源服务器的 IP 地址。即使你找到了,主机也可能会拒绝你的请求。
- 如果你有原始IP,你可以尝试 从源服务器请求数据找到原始 IP 后,您可以尝试将其粘贴到 URL 栏中,但这可能会失败,因为请求缺少有效的 主办方 标头指示您要访问哪个特定网站。 卷曲 允许您在请求源服务器的 IP 地址时指定主机标头。不幸的是,这种方法经常会失败,因为许多源服务器只接受来自受信任 IP 地址的流量。
- 你也可以 对 Cloudflare 的反机器人系统进行逆向工程 找到解决方法。本质上,逆向工程就是将整个系统拆开,弄清楚它是如何工作的。彻底了解一个系统可以帮助您找到绕过它的漏洞。如果您有这方面的技能,逆向工程可能是一种经济有效的解决方案,特别是如果您打算抓取大量数据。然而,Cloudflare 的反机器人系统故意设计得难以理解,而且它往往会经常变化,所以这种方法绝对不适合所有人。
- 当您访问受 Cloudflare 保护的网站时,您必须首先等待 Cloudflare 等候室。这是一个虚拟流量控制系统,可暂时阻止您访问目标网站。在等待期间,您的浏览器会解决挑战以证明您不是机器人。如果一切顺利,您将被重定向到网页。但是,如果您被标记为机器人,您将收到“访问被拒绝”错误。 您还可以 逆向分析 Cloudflare 的等候室挑战 通过检查网络日志和调试挑战脚本来实现。但这也需要很高的编程技能水平。
结语
有几种方法可以绕过 Cloudflare,但选择哪种方法取决于您拥有的资源量、您计划进行的抓取量,甚至您的技能水平。
如果您正在寻找更便宜的选择,您可以抓取网站的缓存版本,尝试对反机器人系统进行逆向工程,或者获取开源 Cloudflare 解决方案。虽然这些方法并不完美,但对于精通技术的人和那些想要省钱的人来说,它们非常有用。另一方面,代理和网络抓取 API 更昂贵,但也更高效。它们可靠、相对简单易懂,成本通常取决于您使用的流量。
