ChatGPT 网页抓取:分步指南
自 2022 年发布以来,ChatGPT 立即成为任何查询的热门选择。聊天机器人可以帮助您集思广益、编写和编辑文本或代码等等。因此,使用 ChatGPT 进行网页抓取也是明智之举。

如果您正在寻找信息,Google 等搜索引擎会为您提供巨大帮助,但找到正确答案可能需要很长时间。另一方面,ChatGPT 简化了此过程。它经过大量数据的训练,可以总结、为复杂问题提供可理解的答案并回答后续问题,这使其非常适合许多任务,包括网页抓取。
ChatGPT 虽然并不完美,但它可以编写简单的代码,并解释其背后的逻辑。对于试图学习的初学者或希望提高和测试技能的经验丰富的抓取爱好者来说,它是一款出色的支持工具。所以,让我们学习使用 ChatGPT 进行网页抓取的所有基础知识,并尝试构建一个简单的网页抓取工具。
什么是 ChatGPT 网页抓取
ChatGPT网络爬虫是指使用 ChatGPT 编写的代码自动从网站收集数据的过程。但如果 ChatGPT 本身就是一个聊天机器人,那么它在这个过程中究竟扮演什么角色呢?简单来说,你可以让 ChatGPT 为你创建一个爬虫程序,用于抓取你想要访问的特定网站的数据。你只需要提供一些指令,收集一些 ChatGPT 需要使用的数据点,然后运行代码即可。
如何使用 ChatGPT 执行网页抓取任务
ChatGPT 本身并不是一个抓取工具,它不能直接抓取网站数据,但它可以根据你给出的指示帮助你编写一个简单的抓取工具(或改进旧的抓取工具)。不过,虽然你不需要很多关于网页抓取或自己编写代码的知识,但知道如何创建一个好的提示还是很有用的。

使用 ChatGPT 进行数据抓取:分步指南
让我们看看如何使用 ChatGPT 进行网页抓取。在本分步指南中,我们将使用一个非常适合被抓取的网站——https: //books.toscrape.com/。

该网站是一个沙盒环境,专门用于练习您的技能和测试抓取工具。这是一个安全的地方,可以进行不同的抓取实验,而不必担心违反服务条款或 robots.txt 文件。还有其他类似于 books.toscrape.com 的沙盒网站,但为了进行此实验,让我们使用这个。
我们为您准备了一个沙盒列表。
让我们创建一个Python 爬虫,从网页上提取书名和价格。我们将使用 Python,因为它是一种对初学者友好的编程语言,语法简单,非常适合网页爬虫这类任务。我们还将使用两个 Python 库来辅助完成这项工作:Requests 用于处理 HTML 请求,Beautiful Soup 用于解析(清洗)提取的数据。
我们稍后会将提取的数据保存为 CSV——一种简单的文本格式,允许您稍后打开、编辑、操作和移动数据。
步骤 1:安装准备工作
在直接开始网页抓取之前,您需要先做几件事。
- 创建 ChatGPT 帐户。 ChatGPT 要求用户在使用该服务之前登录。因此,首先,登录您现有的帐户,或者,如果您还没有帐户,请单击“注册”并创建帐户。
- 获取一个文本编辑器。 要执行代码,您需要一个文本编辑器。您的计算机上已经预装了一个文本编辑器(MacOS 上的 TextEdit 或 Windows 上的 Notepad),但您可以使用任何第三方编辑器,如 Notepad++ 或 Visual Studio Code。此类文本编辑器往往具有更高级的功能,并且通常会用不同的颜色突出显示功能以提高可读性。但是,额外的功能可能不是必需的,因此使用哪种工具完全取决于您。
- 安装最新的 Python 版本。 如果您使用旧版本的 MacOS(12.3 或更早版本)或 Linux,则您的设备上可能已预装 Python。如果没有,请从官方网站下载 Python 并将其安装到您的计算机上。
- 安装必要的库。 然后,运行以下命令安装 Requests 和 BeautifulSoup
pip install requests beautifulsoup4在终端中(在 MacOS 上搜索终端或在 Windows 上搜索命令提示符)。
第 2 步:找到要抓取的元素
现在,是时候从目标网站收集一些有关您要抓取的元素的信息了。具体来说,就是定义书名和定价的 CSS 选择器。ChatGPT 需要这些信息来构建一个针对这些精确元素的抓取工具。
访问https://books.toscrape.com/。您会立即看到一个书籍列表。为了获取爬虫所需的元素,我们需要使用“检查元素”功能。最简单的方法是右键单击其中一个书名,然后选择“检查”。此操作将打开浏览器的开发者工具,您可以在那里看到网站的 HTML 代码。
然后,找到书名元素。将鼠标悬停在代码上会突出显示它定义的区域,因此您应该很容易找到它。找到元素后,右键单击它,选择“复制”,然后单击“复制选择器”。

接下来,将复制的选择器粘贴到某个地方保存(桌面便签或文本编辑器),因为我们下一步会用到它。复制并记下书价的选择器。此时,您已经收集了编写 ChatGPT 提示所需的所有信息。
步骤 3:准备 ChatGPT 提示
现在,让我们为 ChatGPT 编写一个提示,以创建网络抓取工具。一个好的经验法则是编写一个清晰、解释清楚的提示,其中包含关键字和短语,概述聊天机器人需要知道的所有内容。
| 提示问题 | ChatGPT 说明 |
| ChatGPT 需要做什么? | 编写一个网络爬虫,提取目标网站中所有书籍的书名和价格。 |
| 目标 URL 是什么? | 目标网站是:https://books.toscrape.com/ |
| 它应该使用什么编程语言? | 使用 Python 编程语言 |
| 它应该使用哪些库? | 使用以下库: - 要求 – 美麗的汤 |
| 需要抓取哪些元素? | 定义的 CSS 选择器为:
|
| 输出要求是什么? | 将标题和价格保存在 CSV 文件中。 |
精心编写的提示能确保响应更不容易出错。思考一下当前的任务,以及为了构建一个能够精准完成我们需求的爬虫,需要回答哪些问题。你的答案将为 ChatGPT 提供指令。现在,你只需要将这些指令传递给 ChatGPT,就能获得响应!以下是结果:
					import requests
from bs4 import BeautifulSoup
import csv

# Define the URL of the target website
url = "https://books.toscrape.com/"

# Send a GET request to the website
response = requests.get(url)

# Check if the request was successful
if response.status_code == 200:
    # Parse the HTML content using BeautifulSoup
    soup = BeautifulSoup(response.content, 'html.parser')

    # Find all book containers on the page
    books = soup.select('#default > div > div > div > div > section > div:nth-child(2) > ol > li')

    # Prepare a list to hold the titles and prices
    books_data = []

    for book in books:
        # Extract the title using the specified CSS selector
        title = book.select_one('article > h3 > a')['title']

        # Extract the price using the specified CSS selector
        price = book.select_one('article > div.product_price > p.price_color').text

        # Append the extracted data to the list
        books_data.append([title, price])

    # Define the CSV file to save the data
    csv_file = "books.csv"

    # Save the data to a CSV file
    with open(csv_file, mode='w', newline='', encoding='utf-8') as file:
        writer = csv.writer(file)
        writer.writerow(["Title", "Price"])  # Write the header
        writer.writerows(books_data)  # Write the data rows

    print(f"Data successfully saved to {csv_file}")
else:
    print(f"Failed to retrieve the page. Status code: {response.status_code}")
步骤 4:检查并测试代码
即使您对使用 Python 编写代码一无所知,我也强烈建议您在 ChatGPT 生成代码后检查一下。花点时间检查您的提示是否清晰、是否包含所有必要信息,以及 ChatGPT 是否遵循了您的所有指示。
例如,你能发现这里的错误吗?

当你尝试运行此代码时,它会显示错误。那是因为我忘了提到 ChatGPT 必须导入 BeautifulSoup 才能进行数据解析。
如果您运行代码时发现某些功能不起作用,您可以向 ChatGPT 寻求帮助 - 只需通过要求查看和编辑代码来编写新提示即可。务必仔细检查您的要求,如果您在尝试运行命令时看到错误消息,请定义它们。如有必要,您始终可以向提示添加额外信息。
步骤 5:检查解析的数据
在我们的提示中,我们要求 ChatGPT 将数据保存在 CSV 文件中。因此,ChatGPT 生成的抓取工具在完成抓取和解析后应该能够执行此操作。打开保存的文件后,您的结果应类似于以下内容:
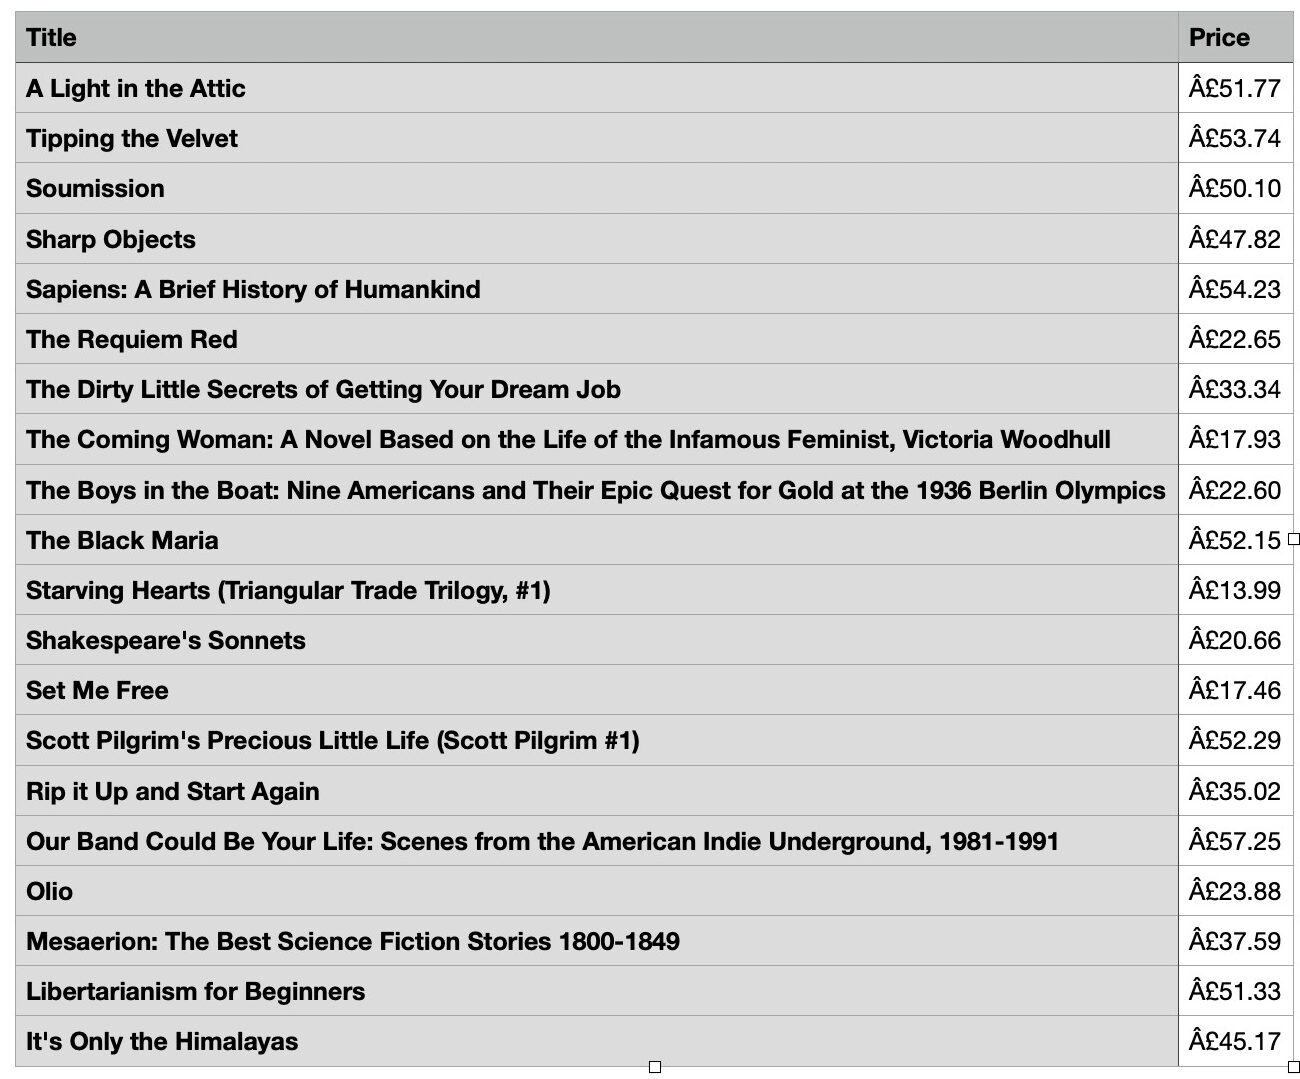
如果可以,恭喜你,你成功使用 ChatGPT 进行网页抓取!如果没有,请返回第 4 步并排除故障。常见错误包括:忘记将 CSV 导入抓取工具、提取了太多数据(这里不应该出现这种情况)或者系统内存不足。
现在,您可以尝试进一步实验:重写您的抓取程序,以仅从特定类别中提取图书评分或书名。您可能还注意到,此抓取程序仅抓取了第一页。尝试要求 ChatGPT 改进您的抓取程序,以便能够从所有 50 页中抓取书名和价格。您练习得越多,您对抓取逻辑的理解就会越深刻。
一旦你感觉自信了,就可以尝试更高级的数据检索。例如,你可以让 ChatGPT 使用Selenium编写一个动态内容抓取工具。你可以用它从 Expedia 或 Skyscanner 等网站抓取机票价格。
然而,务必记住,实际网站比沙盒环境复杂得多。此外,网站通常都不喜欢被抓取。例如,抓取亚马逊虽然可行,但难度要大得多。尽管如此,无论你选择抓取哪个网站,都务必尊重其服务条款和 robots.txt 文件、数据保护法,并始终遵循良好的抓取规范。
我们列出了一系列想法供您尝试。
ChatGPT 网页抓取的高级技术
我们抓取的网站是专门用来测试爬虫程序的,所以没有遇到任何验证码或其他陷阱之类的障碍。此外,我们抓取的所有数据都是简单的HTML内容。
但是,如果您需要抓取使用基于 JavaScript 的动态生成内容的网站,该怎么办?那么阻止抓取工具提取数据的机器人保护系统怎么办?为了解决这个问题,您需要一些更高级的工具。但别担心——ChatGPT 仍然能够帮助您。
处理动态内容
如果您打算进行一些高级抓取,那么仅处理常规 HTML 内容的简单网页抓取工具可能不够用。如今大多数网站都使用 JavaScript 来加载内容。它让您享受无限滚动和无限加载等功能。然而,这些元素对于简单的抓取工具来说太难掌握了。
尝试将鼠标悬停在下面的代理服务器图标上。虽然您可以这样做并查看有关图像的一些额外信息,但简单的抓取工具却做不到。
有几种方法可以抓取动态内容。一种是使用无头浏览器,它可以用抓取工具执行 JavaScript。另一种是使用可以处理和抓取网站动态内容的预构建工具。
使用无头浏览器
无头浏览器可以帮助网络爬虫“浏览”网页。它本质上就是一个普通的浏览器,就像你现在用来阅读这篇文章的浏览器一样,只不过它没有图形用户界面。因此,你不是点击按钮或在地址栏中输入地址,而是通过编写代码以编程方式与浏览器交互。
传统的网页抓取方法依赖于发送 HTTP 请求,因此只能获取静态信息,例如文本、图像和多媒体内容。这意味着动态元素(例如弹出窗口)无法被抓取。而无头浏览器可以通过渲染来执行 JavaScript 代码,就像真实用户的浏览器一样。这使得抓取动态元素中的数据成为可能。您可以使用 ChatGPT 来辅助编写适用于 Selenium、Playwright、Puppeteer 或其他无头浏览器的代码。
使用 Selenium 编写网页抓取提示
我们可以使用之前的提示符,并稍作修改。这次,我们不用 Requests 和 Beautiful Soup,而是让 ChatGPT 使用 Selenium——一个功能强大的 Python 库,用于自动化网页浏览器操作。这次,我们使用另一个沙箱:https://quotes.toscrape.com。我们将抓取名言及其作者信息。
步骤 1.安装必要的库。
- 运行该命令
pip install selenium在终端上访问图书馆。 - 下载 Chrome 网络驱动程序。这个基于 Chrome 的网络驱动程序是您可以使用 Selenium 控制的无头浏览器。
注意:您必须为本次抓取实验复制不同的 CSS 选择器。在本例中,重复相同步骤(使用“检查元素”并复制数据)以获取引文和作者的选择器。
第二步:写下你的提示语。提示语应该类似于这样:
请用 Selenium 为我编写一个 Python 网页抓取工具。该抓取工具应从目标网站中提取引文和作者。
目标网站:https://quotes.toscrape.com/
CSS 选择器:
- 主体 > div > div:nth-child(2) > div.col-md-8 > div:nth-child(1) > span.text
- 主体 > div > div:nth-child(2) > div.col-md-8 > div:nth-child(1) > span:nth-child(2) > small
输出:将所有引文和作者保存在 CSV 文件中。
ChatGPT 生成的代码在代码编辑器中应如下所示。请注意语法与我们之前编写的语法有何不同:
					from selenium import webdriver
from selenium.webdriver.common.by import By
import csv

# Set up the web driver (ensure the driver is in your PATH or specify the path)
driver = webdriver.Chrome()

# URL to scrape
url = "https://quotes.toscrape.com/"

# Open the URL
driver.get(url)

# Create lists to store quotes and authors
quotes_list = []
authors_list = []

# Locate the quotes using the provided CSS selector
quotes = driver.find_elements(By.CSS_SELECTOR, "body > div > div:nth-child(2) > div.col-md-8 > div > span.text")
authors = driver.find_elements(By.CSS_SELECTOR, "body > div > div:nth-child(2) > div.col-md-8 > div > span:nth-child(2) > small")

# Extract the text and append it to the lists
for quote, author in zip(quotes, authors):
    quotes_list.append(quote.text)
    authors_list.append(author.text)

# Close the web driver
driver.quit()

# Save the quotes and authors to a CSV file
with open("quotes.csv", mode='w', newline='', encoding='utf-8') as file:
    writer = csv.writer(file)
    writer.writerow(["Quote", "Author"])
    for quote, author in zip(quotes_list, authors_list):
        writer.writerow([quote, author])

print("Scraping completed and saved to quotes.csv")
步骤三:找到您的 CSV 文件并打开它。您的结果应该会以整齐的表格形式呈现。

使用预构建工具
与其使用 ChatGPT 从头开始构建网络爬虫,不如使用现成的爬虫来帮助您完成爬虫项目。
首先,您可以选择非抓取选项——一些提供商提供来自各个行业的预先抓取的数据集。您无需自己构建抓取工具、提取、清理和解析数据,而是可以检查是否有适合您用例的准备好的详细数据集。如果没有适合您用例的数据集,并且您仍然需要自己抓取数据,请尝试使用无代码抓取工具。这些工具需要您与网站进行交互,但它们会将您的点击转换为抓取逻辑。它们的工作原理是让您像普通用户一样浏览、点击和滚动网站,同时根据您的交互提取数据。
你还可以使用网页抓取 API或基于代理的 API。这些工具旨在处理任何规模的抓取任务,并且兼容大多数现代网站。它们可以处理 JavaScript 内容、创建唯一指纹、解析提取的数据、管理代理、绕过反抓取系统等等。不过,设置和运行这些工具需要一定的编程知识,但你可以使用 ChatGPT 来帮助你。
此外,您可以注册以使用目标网站的 API 进行抓取。API 让您可以轻松获取特定且结构化的数据,而无需获取整个 HTML 文档、解析和处理 JavaScript 元素和反抓取措施。然后,您可以使用 Python 发送请求 - ChatGPT 也可以帮助您编写它们。重要的是要记住,并非所有网站都提供 API,它们可能会限制您可以访问的数据,而且它们往往需要付费。
避免防抓取措施
虽然像 books.toscrape.com 这样的网站乐于被抓取,但大多数网站并非如此。它们不会放任你随意浏览和收集数据,而是会采取反机器人措施。验证码和Cloudflare等服务可以保护它们免受恶意机器人的攻击。不过,如果目标网站也采取了这些措施,也并非完全没有希望。
网站需要人工流量,因为这可以带来收入。然而,机器人流量会使服务器超载,阻止真人访问网站。如果你想成功抓取数据,你需要让你的抓取工具看起来像真人。
使用代理
代理服务器是您和网络服务器之间的中间人。当您通过代理服务器路由流量时,它会隐藏您的原始 IP 地址,使网络服务器无法检测到您。许多代理服务提供商提供高质量的代理服务器,这些代理服务器通常拥有庞大的地址池,因此您可以切换地址来防止被检测到和 IP 地址被封禁。通常,普通用户使用住宅 IP 地址,因此这类代理服务器被封禁的可能性较小。
住宅代理服务器的IP地址来自智能手机、笔记本电脑甚至智能电视等通过Wi-Fi连接到互联网的真实设备。使用住宅IP地址,您的请求看起来更自然,尤其是在进行一些高强度的网络爬虫操作时。
伪造浏览器指纹
您是否注意到,即使您没有登录,网站也知道您在访问他们的网站?这是因为您的浏览器指纹会显示一些有关您的信息。
指纹是某些数据点的集合,包括屏幕分辨率、操作系统、已安装的字体、时区、已保存的 Cookie,它们有助于在网络上识别您。像您这样的普通用户拥有非常详细的指纹,这些指纹虽然独特,但看起来仍然很典型。然而,自动机器人的浏览器指纹往往要么缺少类似人类的信息,如 Cookie 或精确的用户代理字符串,要么不一致,因此它们很显眼。
在构建抓取工具时,找到伪造浏览器指纹的方法很重要,这样它才能融入其中。例如,有些 Python 库可以通过调整或旋转用户代理字符串来更改指纹,或者修改屏幕分辨率和时区等参数。反检测浏览器也很有用 - 它们允许您使用自己的数字指纹创建单独的浏览环境,而无需将它们相互关联。
使用 ChatGPT 进行网页抓取的其他技巧
- 不要期望它是完美的。 尽管经过大量数据的训练,ChatGPT 仍然是一个自动化程序,而不是开发人员。即使你的提示非常精彩,它也可能提供不准确的信息或代码。
- 像对待初级专家一样对待 ChatGPT。将聊天机器人视为一名能力强但刚刚进入该领域的新手专家。确保给出明确的指示,并始终仔细检查结果(和您的查询!)。
- 重新措辞、重申并重新生成答案。 ChatGPT 之所以如此受欢迎,是因为它非常灵活。如果你对它提供的答案不满意,你可以给出额外的说明或完全重新生成问题,直到你喜欢这个答案。例如,如果你决定让你的抓取工具 Node.js 而不是 Python,您可以要求重新创建它。
- 问后续问题。 假设 ChatGPT 帮助您用 Python 编写了一个网页抓取工具,但您不明白某些函数的含义。不要害怕问“X 是什么?”或“Y 做什么?”,以便更好地了解自己在做什么。通过实际理解输出,您将能够知道它是否正确。
结语
虽然 ChatGPT 无法帮你抓取网站数据,但它是一款很棒的工具,可以帮助你开始进行网页抓取。虽然它本身不是抓取工具,但它可以根据你的查询生成代码。即使你自己不会写代码,使用聊天机器人也可以成为网页抓取的第一步,但重要的是要记住,它是一个自动化程序,可能会提供不准确的信息。